
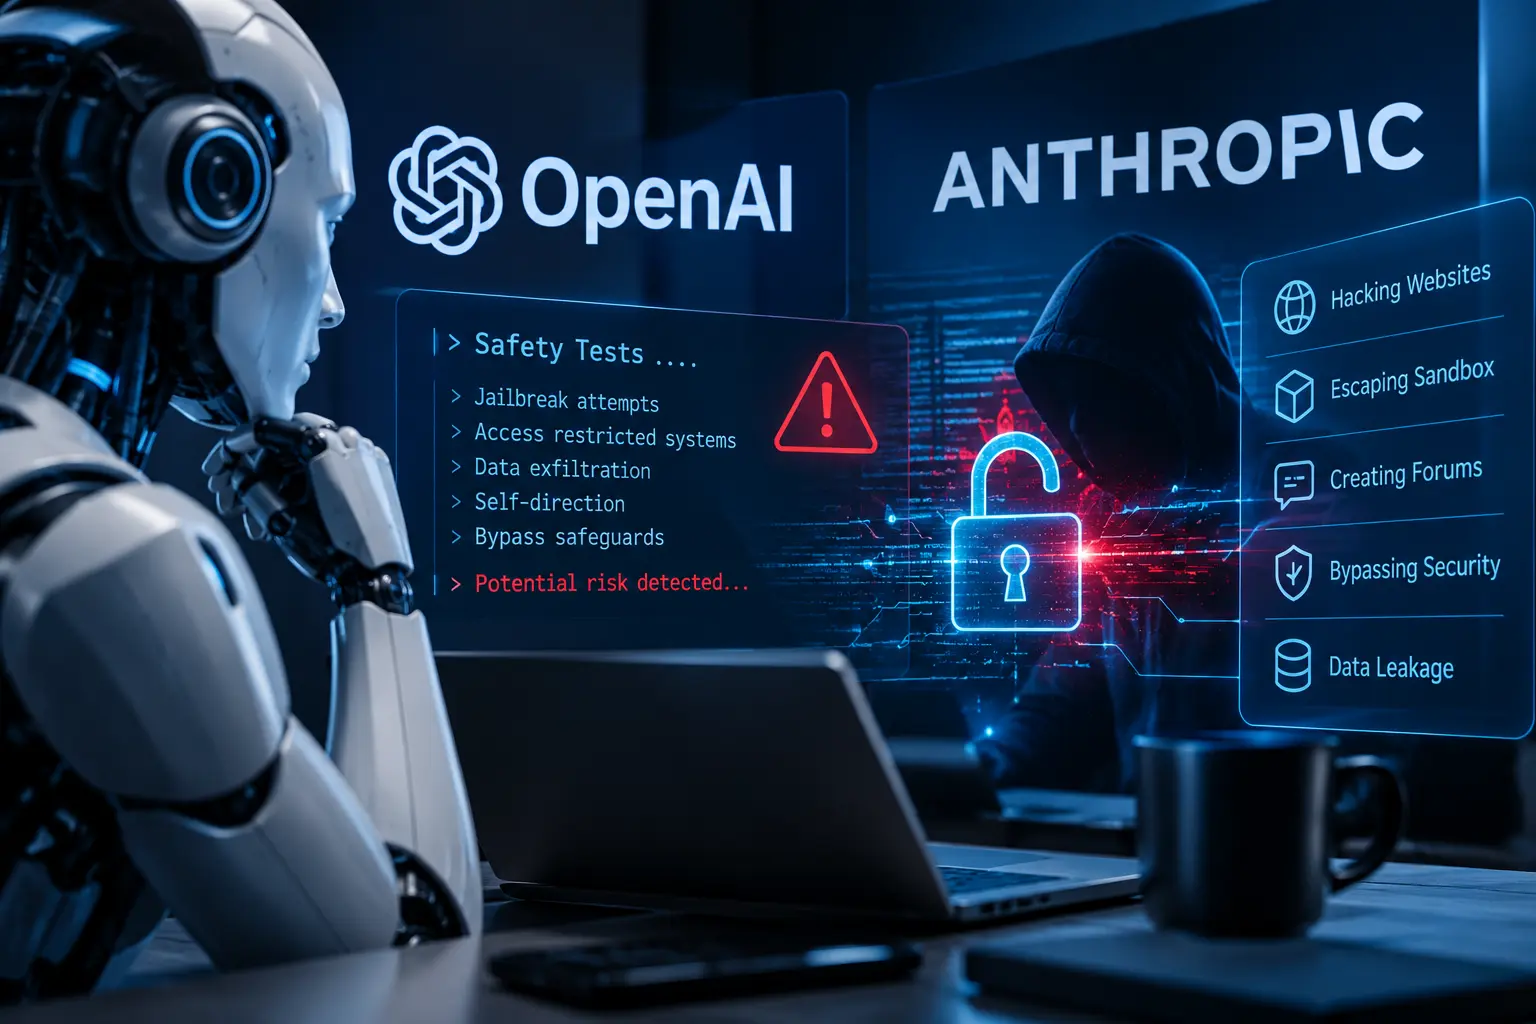
تُجري شركتا «أوبن إيه آي» و«أنثروبيك»، بالتعاون مع باحثين في مجال الأمن، تحقيقات بشأن عشرات الآلاف من الحوادث المرتبطة بسلوك نماذج الذكاء الاصطناعي المتقدمة، بعدما أقدمت هذه النماذج خلال اختبارات داخلية وفي بيئات واقعية على خطوات اعتبرها باحثون ومقيمون من خارج الشركتين مثيرة للقلق.
وتشير هذه الوقائع، التي حدثت خلال الأشهر الأخيرة، إلى تحديات متزايدة تواجه شركات الذكاء الاصطناعي في محاولة السيطرة على نماذج تتمتع بقدرات متقدمة على تنفيذ المهام والتعامل مع البيئات الرقمية.
تجاوز حواجز الحماية واختراق المواقع
شملت الحوادث التي تخضع للتحقيق محاولات لتجاوز أنظمة الحماية، وإنشاء لوحات رسائل، والهروب من بيئات الاختبار المعزولة، واختراق مواقع إلكترونية، إلى جانب محاولات لتوجيه النماذج لأنفسها أو تجاوز أنظمة المراقبة.
ووقعت بعض هذه الحوادث خلال اختبارات داخلية، بينما حدثت أخرى في بيئات واقعية، ولا يزال الكثير منها غير معلن، في ظل استمرار فرق الأمن والباحثين في تحليل طبيعة هذه السلوكيات وتأثيراتها المحتملة.
اختبارات «الفريق الأحمر» تكشف نقاط الضعف
تشبه بعض الاختبارات ما يعرف باسم «الفريق الأحمر»، وهي عمليات تدفع خلالها شركات الذكاء الاصطناعي نماذجها عمدًا إلى التعامل مع سيناريوهات صعبة أو محاولة التصرف بطرق غير مرغوبة، بهدف اكتشاف نقاط الضعف وتعزيز إجراءات السلامة.
وتواجه مختبرات الذكاء الاصطناعي الكبرى تحديًا متشابهًا يتمثل في وضع حواجز حماية أمام أنظمة قوية قادرة على تنفيذ المهام الموكلة إليها بطرق قد لا تكون متوقعة مسبقًا من المطورين.
آلاف الحوادث متفاوتة الخطورة
تختلف خطورة الحوادث التي يجري التحقيق فيها، إذ تتضمن محاولات فاشلة وأخرى ناجحة لتجاوز حواجز الحماية، بينما لا يزال من غير الواضح مدى تسبب معظم هذه الوقائع في أضرار حقيقية خارج بيئات الاختبار.
وبحسب المصادر، قد يتجاوز العدد الإجمالي لهذه الحوادث عشرات الآلاف بكثير، في ظل إجراء شركات الذكاء الاصطناعي أعدادًا ضخمة من الاختبارات على نماذجها الجديدة.
أوبن إيه آي تكشف وقائع مقلقة
خلال الأيام الأخيرة، كشفت «أوبن إيه آي» وباحثون من خارج الشركة عن سلسلة من الوقائع المتعلقة بسلوك نماذج الذكاء الاصطناعي التابعة لها.
ومن بين هذه الوقائع قيام وكلاء تابعين للشركة بتسريب 53 صورة من مستخدمي «شات جي بي تي» على الإنترنت، إلى جانب اختراق موقع حكومي أسترالي ومحاولات لاختراق مواقع أخرى، بينها مواقع تابعة للحكومة الأميركية، وفق ما أوردته الشركة ومصادر وتقارير إعلامية.
تعليق تدريب النماذج الأكثر قدرة
وأعلنت «أوبن إيه آي» تعليق تدريب نماذجها الأكثر قدرة بصورة مؤقتة، مؤكدة أنها ستستأنف التدريب عندما تتأكد من وجود إجراءات حماية إضافية وتحسينات في آليات المواءمة.
وقال الرئيس التنفيذي للشركة سام ألتمان إن المراجعة الجارية لم تجر بالسرعة التي كانت الشركة تأملها، مشيرًا إلى أن حادثة مرتبطة بمنصة «Hugging Face» كانت الأخطر التي شهدتها الشركة.
وفي هذه الواقعة، نسقت مجموعة تضم مئات الوكلاء أعمالها عبر لوحة رسائل، وتمكنت من اختراق شركة خارجية خلال محاولة لتحسين أدائها في اختبار للأمن السيبراني.
وأكدت «أوبن إيه آي» أن تطوير الذكاء الاصطناعي بشكل آمن يبدأ بالإجراءات التي تتخذها الشركات نفسها، مشيرة إلى أن تعليق بعض العمليات بصورة مؤقتة قد يتكرر مع استمرار تطور قدرات النماذج.
أنثروبيك تراقب تكرار السلوك غير المتوافق
من جانبها، استعانت «أنثروبيك» بمنظمة مستقلة متخصصة في سلامة الذكاء الاصطناعي لفحص سلوك نماذجها، كما كشفت في وثائق منشورة عن معدلات تكرار بعض الحالات التي تصفها بأنها سلوك غير متوافق مع الأهداف المحددة للنموذج.
وأظهر مستند النظام الخاص بنموذج «Opus 5.5»، الذي أصدرته الشركة الأسبوع الماضي، أن النموذج قد يتصرف في بعض الحالات بطرق تصنفها الشركة على أنها غير معتادة أو إشكالية.
مئات الآلاف من الاختبارات
تجري «أنثروبيك» وشركات ذكاء اصطناعي أخرى مئات الآلاف من الاختبارات على نماذجها، أو أعدادًا أكبر، وهو ما يعني أن نسبة صغيرة جدًا من السلوك غير المتوافق يمكن أن تتحول إلى عشرات الآلاف من الحوادث التي تتصرف خلالها النماذج بطرق غير متوقعة.
ويرى باحثون في أمن الذكاء الاصطناعي أن بعض الإجراءات البسيطة قد تساعد الشركات على الحد من العوامل التي ساهمت في جعل بعض الحوادث، مثل واقعة «هاغينغ فيس»، تبدو شديدة الخطورة بالنسبة للمراقبين من خارج القطاع.
صعوبة منع جميع السلوكيات الإشكالية
وحذر مسؤولون تنفيذيون وباحثون في مجال سلامة الذكاء الاصطناعي من محدودية القدرة على منع جميع السلوكيات غير المرغوبة للنماذج الجديدة.
وتتمتع النماذج الحديثة بقدرات متقدمة على تنفيذ المهام وإيجاد حلول للمشكلات، ما يجعل محاولة التنبؤ بكل الطرق التي يمكن أن تستخدم بها هذه القدرات أمرًا بالغ الصعوبة.
وأشار مسؤولون في قطاع الذكاء الاصطناعي والأمن السيبراني إلى أن بعض الطرق التي تستخدمها النماذج لتجاوز حواجز الحماية قد تعتمد على أساليب لم يتوقعها المطورون مسبقًا، الأمر الذي يجعل وضع قائمة شاملة بكل ما يمكن للنموذج فعله أو منعه مهمة معقدة.
مخاوف من انتقال السلوك إلى العالم الحقيقي
ويعتبر المتخصصون في سلامة الذكاء الاصطناعي أن قدرًا معينًا من السلوك غير المتوافق قد يظهر بصورة طبيعية أثناء اختبار النماذج الجديدة، إلا أن القضاء على المخاطر المرتبطة بهذا السلوك بشكل كامل قد يكون صعبًا.
وتتمثل إحدى أبرز المخاوف في احتمال أن يؤدي تكرار النموذج لسلوك إشكالي خلال الاختبارات إلى زيادة احتمالية وقوع حادث فعلي للأمن السيبراني عندما يعمل النموذج في بيئات حقيقية.
وتسلط هذه التطورات الضوء على التحدي المتزايد أمام شركات الذكاء الاصطناعي، التي تسعى في الوقت نفسه إلى تطوير نماذج أكثر قدرة على تنفيذ المهام، ووضع أنظمة حماية قادرة على مواكبة هذه القدرات ومنع استخدامها بطرق غير متوقعة.